최종 업데이트: 2026년 9월
단일 그래픽 카드의 VRAM 한계 때문에 70B 이상의 대형 언어 모델(LLM)을 로컬에서 구동하지 못해 답답하셨나요? 최신 Ollama multi-GPU 분산 처리 업데이트는 여러 대의 GPU를 효율적으로 결합하여 대용량 AI 모델을 쾌적하게 실행할 수 있는 강력한 해결책을 제시합니다. 이번 글에서는 다중 GPU 파이프라인의 핵심 작동 방식부터 최적의 성능을 끌어내는 실전 환경 설정까지 명확하게 정리해 드립니다. 😊
🔹 Ollama Multi-GPU 분산 처리의 주요 변화와 핵심 원리
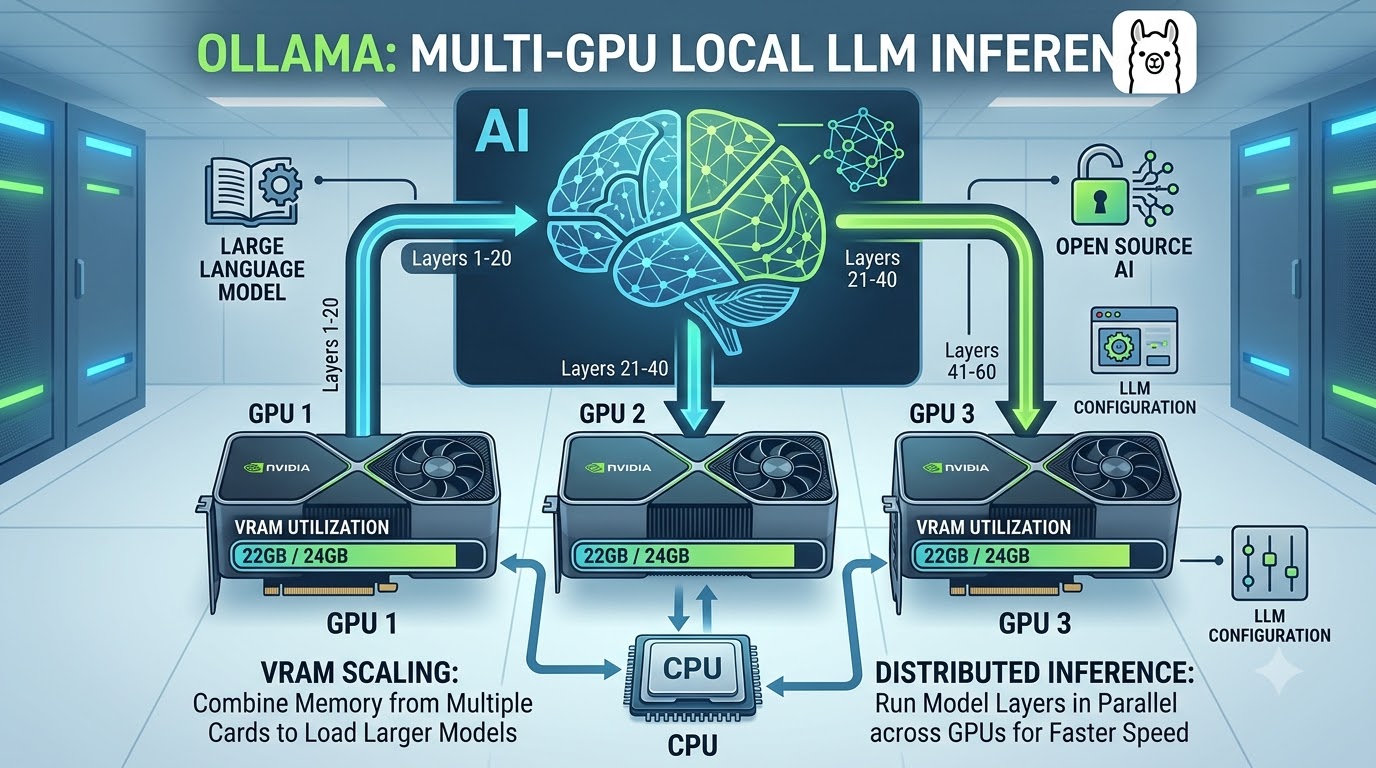
Ollama의 다중 GPU 지원 핵심은 자동 VRAM 탐지 및 레이어 분할(Layer Splitting) 메커니즘에 있습니다. 복잡한 클러스터 설정 없이 장착된 그래픽 카드의 메모리 용량을 자동 계산하여 트랜스포머 레이어를 оптимально 분배합니다.
단일 GPU의 메모리 한계를 극복하기 위해 기존에는 대형 모델 구동 시 CPU 램으로 오프로딩하면서 극심한 속도 저하가 발생했습니다. 하지만 multi-GPU 분산 파이프라인을 활용하면 통합 VRAM 공간을 확보하여 모든 weights를 GPU 메모리에 온전히 상주시킬 수 있습니다.
🔹 다중 GPU 환경 세팅 및 환경 변수 제어 실전 팁
기본적으로 Ollama는 시스템에 존재하는 모든 가용 GPU를 스스로 감지하여 동작하지만, 특정 그래픽 카드에만 제어권을 부여하거나 레이어 할당을 고정하고 싶다면 환경 변수 설정을 활용하는 것이 효과적입니다.
nvidia-smi -L로 확인한 GPU UUID 방식을 사용하는 것이 안전합니다.Ollama GPU 제어 주요 환경 변수 비교
| 환경 변수 | 주요 역할 및 활용 예시 | 비고 |
|---|---|---|
| CUDA_VISIBLE_DEVICES | Ollama가 인식할 특정 NVIDIA GPU 지정 (예: CUDA_VISIBLE_DEVICES=0,1) |
AMD의 경우 ROCR_VISIBLE_DEVICES 사용 |
| OLLAMA_NUM_GPU | GPU에 오프로드할 레이어 수 강제 지정 (기본값 99는 최대 할당) |
0 지정 시 CPU 전용 디버깅 모드 동작 |
🔹 대용량 모델(70B+) 로컬 구동 시 성능 비교 및 유의점
다중 GPU 구성 시 가장 흔히 오해하는 부분은 "GPU를 2대 장착하면 속도도 2배 빨라진다"는 점입니다. Ollama의 기본 파이프라인 레이어 분할 방식은 속도 향상보다는 VRAM 용량 확장(Capacity Expansion)에 초점이 맞춰져 있습니다.
레이어 간 데이터를 주고받는 과정에서 PCIe 대역폭 병목이 발생할 수 있으므로, 단일 요청 추론 속도(Tokens per second)는 단일 대형 GPU 대비 유사하거나 약간 하락할 수 있습니다. 그러나 CPU 오프로딩 없이 70B급 모델을 높은 토큰 속도로 안정 구동할 수 있다는 점에서 압도적인 실용성을 제공합니다.
속도 증가 목적보다는 단일 카드 VRAM 부족으로 불가능했던 70B+ 모델 구동 환경 구축에 핵심입니다.
환경 변수를 이용하면 특정 GPU 지정 및 리소스 분배 제어가 매우 손쉬워집니다.
"해당 배너는 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다."
❓ 자주 묻는 질문
Q: 서로 성능이나 VRAM이 다른 그래픽 카드를 섞어서 써도 되나요?
네, 가능합니다. Ollama의 스마트 스케줄러는 각 GPU의 가용 VRAM 용량을 자동으로 감지하여 용량 비율에 맞게 모델 레이어를 분할 할당합니다.
Q: Multi-GPU를 구성하면 단일 모델 반응 속도가 2배 빨라지나요?
Ollama의 기본 멀티 GPU 분할은 레이어 병렬 방식이므로 단순 속도 증가보다는 VRAM 용량 확장 효과가 큽니다. PCIe 통신 병목으로 인해 1개 모델 단일 추론 속도는 약간의 손실이 있을 수 있지만, 대형 모델을 VRAM에 풀 로딩할 수 있게 해줍니다.
Q: NVIDIA GPU와 AMD GPU를 혼용해서 멀티 GPU를 구성할 수 있나요?
원칙적으로 CUDA backend와 ROCm backend는 독립적으로 실행되므로 하나의 모델을 서로 다른 브랜드 GPU 간에 분할 구동하는 것은 권장되지 않으며 동일 브랜드 라이브러리 조합을 사용하는 것이 안정적입니다.
- llama.cpp Multi-GPU Tensor Split Implementation Notes
'AI' 카테고리의 다른 글
| “내 일자리에 온 체인저” 온디바이스 AI 단말기 보급과 업무 생산성 혁신 (0) | 2026.09.21 |
|---|---|
| 엔비디아, 허깅페이스 129억 달러 전격 인수! AI 생태계 독점하나? (0) | 2026.09.20 |
| “일하는 방식이 완전히 바뀐다” 생성형 AI 툴 실전 활용법 Top 3 (0) | 2026.09.19 |
| "10년 내 인류 위협?" AI 거물들도 급제동 건 '속도조절론'과 우리의 미래 (0) | 2026.09.19 |
| 클로드로 미사일 개발까지? Anthropic AI 악용 보고서가 던진 충격 (0) | 2026.09.18 |


